Was du lernst
- Ein CNN zweimal trainieren — kurz und lang.
- Modelle auf denselben vier Testbildern vergleichen.
- Erkennen, woran ein Modell wirklich scheitert.
- Warum ein pizzaähnlicher Grenzfall so schwer ist.
Wie das System aufgebaut ist
Alles läuft lokal — kein Server, kein Internet.
Input Image (3x64x64)
        |
  [Conv Block 1]  64 filters 3x3, ReLU, MaxPool(2)
        |
  Feature Maps (64x32x32)
        |
  [Conv Block 2]  128 filters 3x3, ReLU, MaxPool(2)
        |
  Feature Maps (128x16x16)
        |
  [Flatten]  128*16*16 = 32768
        |
  [Linear]  32768 -> 256 -> ReLU
        |
  [Linear]  256 -> 1 (sigmoid)
        |
  Output: 0 = not pizza, 1 = pizza
Was ist WSL — und wo finde ich es?
WSL (Windows Subsystem for Linux) ist ein vollwertiges Linux, das direkt in Windows läuft — ohne zweiten Rechner und ohne Neustart. Alle Befehle in dieser Aufgabe tippst du in ein solches Linux-Terminal ein. Auf den Schulungsrechnern ist WSL bereits fertig eingerichtet.
So öffnest du WSL unter Windows (eine der beiden Varianten genügt):
- Startmenü: Windows-Taste drücken, „Ubuntu“ (oder „WSL“) tippen und die App öffnen — es erscheint ein schwarzes Terminalfenster.
- Terminal: Windows Terminal (oder die Eingabeaufforderung) öffnen und
wsleintippen, Enter drücken.
Du bist im richtigen Fenster, wenn die Eingabezeile mit etwas wie benutzer@rechner:~$ endet. Ab hier gelten Linux-Befehle (Bash) — keine PowerShell.
Schritt 0 — Setup prüfen
Bei jedem neuen Terminal: WSL starten (siehe oben), dann diese zwei Zeilen.
cd ~/projects/bpm-pizza-ml
source .venv/bin/activate
Der Check prüft Abhängigkeiten, Datensätze und test_images/:
python3 check_environment.py
Die Ausgabe endet mit:
All dependencies and data are present. You are ready to start.
Die Aufgabe
Jedes Modell wird an diesen 4 Bildern geprüft — vorher ansehen. Flammkuchen ist der absichtliche Grenzfall.
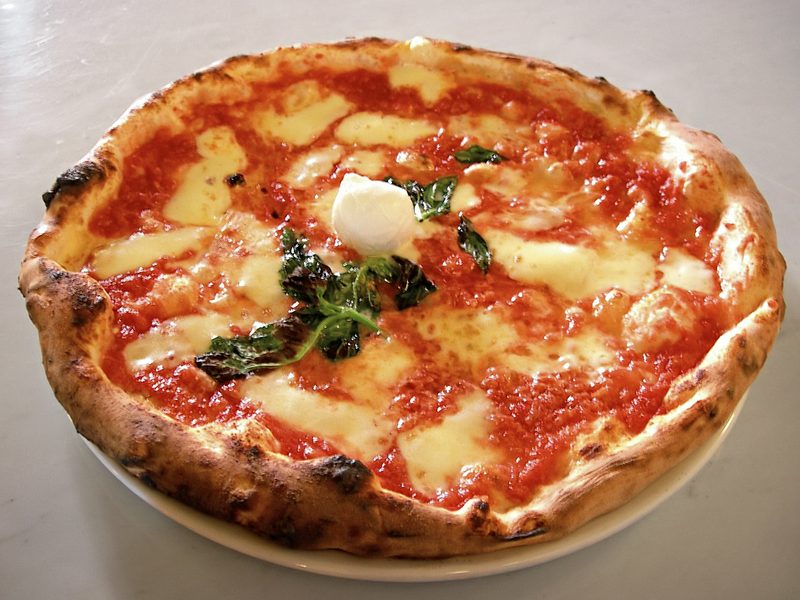
pizza_margherita.jpg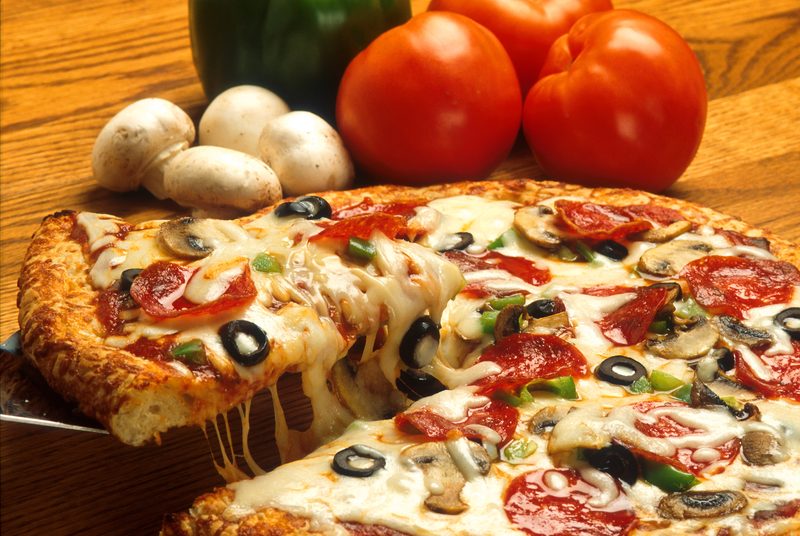
pizza_supreme.jpg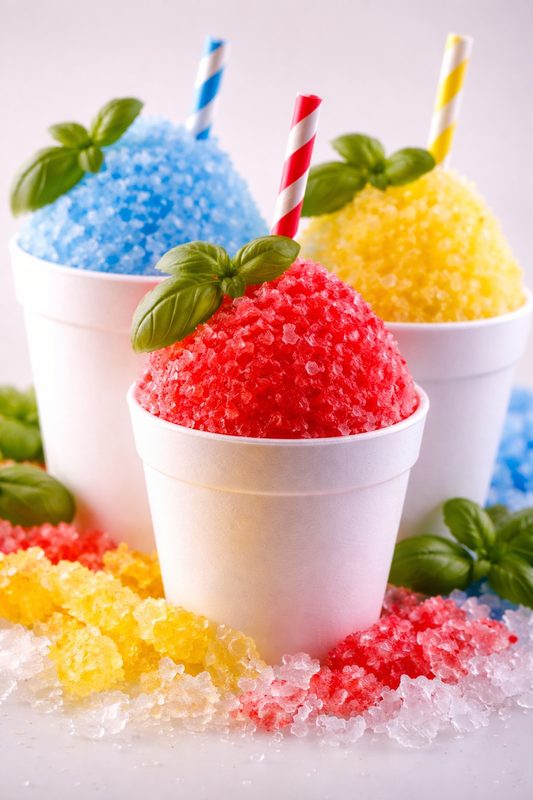
ice.jpg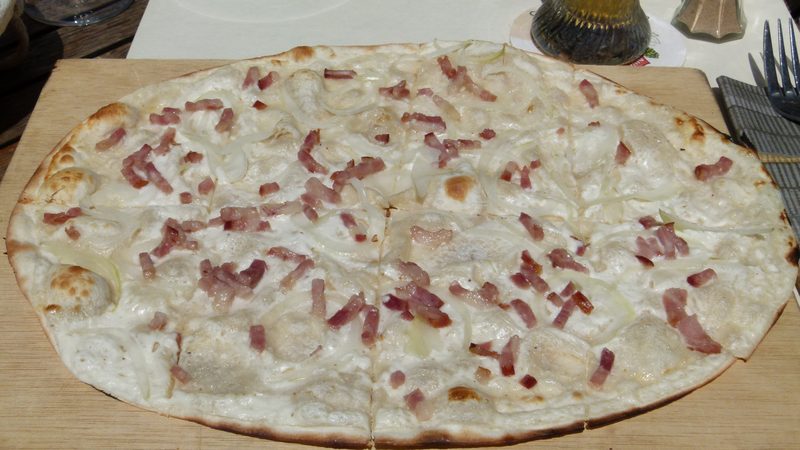
flammkuchen.jpgDas Modell lernt aus data/v1 — der Ordnername (pizza/, not_pizza/) ist das Label — und stellt ~8,6M Parameter ein. Eine Epoch ist ein Durchlauf durch alle Bilder. Trainiere v1 mit 10 und 50 Epochs, dann beide auf den 4 Testbildern vorhersagen:
python3 train-pizza-creation.py --data-dir ./data/v1 --epochs 10 --output pizza_tinyvgg_v1_10.pth
python3 train-pizza-creation.py --data-dir ./data/v1 --epochs 50 --output pizza_tinyvgg_v1_50.pth
if [ -t 1 ]; then GREEN=$'\033[32m'; RED=$'\033[31m'; RESET=$'\033[0m'
else GREEN=""; RED=""; RESET=""; fi

declare -A EXPECTED=(
  [pizza_margherita]="PIZZA"
  [pizza_supreme]="PIZZA"
  [ice]="NOT PIZZA"
  [flammkuchen]="NOT PIZZA"
)

for img in pizza_margherita pizza_supreme ice flammkuchen; do
  echo "======================================================="
  echo "Image: $img.jpg   (expected: ${EXPECTED[$img]})"
  echo "======================================================="
  printf '%-26s %-12s %-12s %s\n' "MODEL" "RESULT" "CONFIDENCE" "STATUS"
  printf '%.0s-' {1..64}; echo
  for model in pizza_tinyvgg_v1_10 pizza_tinyvgg_v1_50; do
    out=$(python3 train-pizza-creation.py --predict test_images/$img.jpg --output $model.pth)
    result=$(echo "$out" | grep -i '^Result:'     | sed 's/^Result: *//')
    conf=$(  echo "$out" | grep -i '^Confidence:' | sed 's/^Confidence: *//')
    if [ -z "$result" ]; then
      result="-"; conf="-"
      status=$(printf '%-6s' "ERROR"); color=$RED
    elif [ "$result" = "${EXPECTED[$img]}" ]; then
      status=$(printf '%-6s' "OK");    color=$GREEN
    else
      status=$(printf '%-6s' "WRONG"); color=$RED
    fi
    printf '%-26s %-12s %-12s %s%s%s\n' \
      "$model" "$result" "$conf" "$color" "$status" "$RESET"
  done
  echo
done
Ein Block, acht Vorhersagen: pro Testbild eine Tabelle.
Trainings-Ausgabe
Starting training for 10 epochs...
======================================================================
Epoch  1/10 | Train Loss: 0.NNNN, Acc: NN.NN% | Test Loss: 0.NNNN, Acc: NN.NN%
  -> Saved best model (acc: NN.NN%)
Epoch  2/10 | Train Loss: 0.NNNN, Acc: NN.NN% | Test Loss: 0.NNNN, Acc: NN.NN%
...
Epoch 10/10 | Train Loss: 0.NNNN, Acc: NN.NN% | Test Loss: 0.NNNN, Acc: NN.NN%
======================================================================
Training complete! Best accuracy: NN.NN%
Model saved to: pizza_tinyvgg_v1_10.pth
Lesehilfe: Links Train Loss und Acc auf den Trainingsbildern, rechts Test Loss und Acc auf zurückgehaltenen Testbildern — nur die rechte Trefferquote zählt. Liegt die linke deutlich höher: Overfitting. -> Saved best model erscheint nur bei einem neuen Bestwert. NN.NN steht für deine eigenen Zahlen.
Vorhersage-Ausgabe
RESULT, NN.NN% und OK|WRONG stehen für deine eigenen Werte:
=======================================================
Image: pizza_margherita.jpg   (expected: PIZZA)
=======================================================
MODEL                      RESULT       CONFIDENCE   STATUS
----------------------------------------------------------------
pizza_tinyvgg_v1_10        RESULT       NN.NN%       OK|WRONG
pizza_tinyvgg_v1_50        RESULT       NN.NN%       OK|WRONG
Lesehilfe: RESULT ist das Urteil, CONFIDENCE die Konfidenz in genau dieses Urteil — daher immer mindestens 50 Prozent. STATUS vergleicht das Urteil mit dem erwarteten Label aus der Kopfzeile: OK grün, WRONG rot. Grün heißt „richtig“, nicht „Pizza“ — ein korrektes NOT PIZZA bei ice.jpg ist grün. ERROR heißt: Vorhersage fehlgeschlagen. Die vier Blöcke sind die Vorlage für die Tabelle in Schritt 5.
Jede Vorhersage druckt diese zwei Zeilen.
Loading TinyVGG model from pizza_tinyvgg_v1_10.pth...

Result: PIZZA
Confidence: NN.NN%
Die v1-Ergebnisse: Was ist schiefgelaufen?
Testgenauigkeit mäßig, 5× mehr Training ändert fast nichts. Mögliche Ursachen:
- Datenqualität?
- Datenmenge?
- Modell-Architektur?
- Trainingsprozess?
- Input-Pipeline?
Trainingsdaten inspizieren
Sieh dir data/v1/train/pizza/ an — findest du Nicht-Pizza-Bilder im Pizza-Ordner? Die Galerie zeigt sie im Browser.
v2 trainieren & vergleichen
Datensatz v2 ist derselbe Datensatz ohne die in Schritt 3 gefundenen Labels. Trainiere beide v2-Modelle auf denselben 4 Testbildern:
python3 train-pizza-creation.py --data-dir ./data/v2 --epochs 10 --output pizza_tinyvgg_v2_10.pth
python3 train-pizza-creation.py --data-dir ./data/v2 --epochs 50 --output pizza_tinyvgg_v2_50.pth
if [ -t 1 ]; then GREEN=$'\033[32m'; RED=$'\033[31m'; RESET=$'\033[0m'
else GREEN=""; RED=""; RESET=""; fi

declare -A EXPECTED=(
  [pizza_margherita]="PIZZA"
  [pizza_supreme]="PIZZA"
  [ice]="NOT PIZZA"
  [flammkuchen]="NOT PIZZA"
)

for img in pizza_margherita pizza_supreme ice flammkuchen; do
  echo "======================================================="
  echo "Image: $img.jpg   (expected: ${EXPECTED[$img]})"
  echo "======================================================="
  printf '%-26s %-12s %-12s %s\n' "MODEL" "RESULT" "CONFIDENCE" "STATUS"
  printf '%.0s-' {1..64}; echo
  for model in pizza_tinyvgg_v2_10 pizza_tinyvgg_v2_50; do
    out=$(python3 train-pizza-creation.py --predict test_images/$img.jpg --output $model.pth)
    result=$(echo "$out" | grep -i '^Result:'     | sed 's/^Result: *//')
    conf=$(  echo "$out" | grep -i '^Confidence:' | sed 's/^Confidence: *//')
    if [ -z "$result" ]; then
      result="-"; conf="-"
      status=$(printf '%-6s' "ERROR"); color=$RED
    elif [ "$result" = "${EXPECTED[$img]}" ]; then
      status=$(printf '%-6s' "OK");    color=$GREEN
    else
      status=$(printf '%-6s' "WRONG"); color=$RED
    fi
    printf '%-26s %-12s %-12s %s%s%s\n' \
      "$model" "$result" "$conf" "$color" "$status" "$RESET"
  done
  echo
done
Vergleiche v2 mit v1: Wie verändert sich die Konfidenz — und was passiert beim Flammkuchen?
Alle vier Modelle vergleichen
Ergebnisse eintragen:
| Metrik | v1+10 | v1+50 | v2+10 | v2+50 |
|---|---|---|---|---|
| Modelldatei | v1_10.pth |
v1_50.pth |
v2_10.pth |
v2_50.pth |
| Testgenauigkeit | ___% | ___% | ___% | ___% |
| pizza_margherita.jpg | ___ | ___ | ___ | ___ |
| pizza_supreme.jpg | ___ | ___ | ___ | ___ |
| ice.jpg | ___ | ___ | ___ | ___ |
| flammkuchen.jpg | ___ | ___ | ___ | ___ |
Abkürzung — nur im Ausnahmefall
Bei Zeitnot trainiert und testet EIN Lauf alle vier Modelle — überspringt aber den Lernweg. Nur nach Rücksprache mit dem Trainer.
./run_all_tests_creation.sh
Lösung — erst öffnen, wenn alle Aufgaben erledigt sind
TinyVGG Inferenz-Ergebnisse
Alle Prozentwerte sind die Konfidenz in das jeweils genannte Urteil (immer mindestens 50%) — dieselbe Konvention wie im Vergleichsbogen. Diese Tabelle ist die einzige Quelle der TinyVGG-Referenzwerte; Aufgabe 2 verweist hierher.
| Bild | v1+10ep | v1+50ep | v2+10ep | v2+50ep |
|---|---|---|---|---|
| pizza_margherita | PIZZA (75.07%) | PIZZA (76.84%) | PIZZA (99.82%) | PIZZA (99.96%) |
| pizza_supreme | PIZZA (75.03%) | PIZZA (76.19%) | PIZZA (94.65%) | PIZZA (96.61%) |
| ice | NOT PIZZA (58%) | NOT PIZZA (58%) | NOT PIZZA (88%) | NOT PIZZA (98%) |
| flammkuchen | NOT PIZZA (52%) | NOT PIZZA (57%) | NOT PIZZA (63%) | PIZZA (63%) |
Erwartete Genauigkeit (Trainingsläufe)
| Modell | Erwartete Genauigkeit |
|---|---|
| Unsauber+10 | ~65–70% |
| Unsauber+50 | ~65–75% |
| Sauber+10 | ~75–80% |
| Sauber+50 | ~80–90% |
Erkenntnisse
Saubere Trainingsdaten zahlen sich aus. Die Konfidenz bei echten Pizzen springt von ~75% auf ~99%. Eis wird mit ~98% Konfidenz sauber als NOT PIZZA abgelehnt (vs. nur ~58% bei v1).
- Flammkuchen sieht aus wie Pizza: flacher Teig, Belag, runde/rechteckige Form
- Mit schlechten Daten (v1) ist das Modell unsicher (~52-57%) und tendiert zu NOT PIZZA
- Mit sauberen Daten und mehr Training (v2+50) kippt es zu PIZZA (63%) — das Modell wird „sicherer“ in der falschen Richtung
- Das zeigt: Dem Modell fehlt eine Klasse für „pizza-ähnlich aber nicht Pizza“ (Flammkuchen, Focaccia, etc.)
v1: 75% → 76% nach 5× mehr Training. Bei sauberen Daten auch nur marginale Gains — Modell konvergiert schnell.
Eine „Flatbread/Flammkuchen“-Klasse oder Negativbeispiele dieser Kategorie im Trainingsset.